-
-
Installation du module Apache rpaf - [Mémo Debian & VDR]
December 18, 2014 - permalink - http://www.mn-home.fr/article46.htmlOk Ok, ça m'aurait évité de modifier le logformat de mon apache..
via arnaudb
-
-
-
etsy/logstash-forwarder
December 11, 2014 - permalink - https://github.com/etsy/logstash-forwarderun listener qui permet d'envoyer un seul evenement logstash pour plusieurs lignes de logs.
Si on a la main sur le code source, c'est quand meme plus simple de logger en json : 1 ligne = 1 event
Dans ce cas on peut utiliser le plugin imfile de rsyslog pour surveiller le fichier et envoyer les events :)
-
Un peu de réseau et de debug udp
December 10, 2014 - permalink - https://links.infomee.fr/shaare/AyHsGAPrenons une application ouvre une socket UDP : pour chaque paquet qui arrive, elle va le traiter et passer au suivant. Si le traitement est plus cours que la cadence de reception, tout va bien, on peut travailler en "flux tendu". Pour éviter de perdre des paquets si l'application est trop lente, le kernel entretien des buffers qui ont une taille par defaut et une taille max.
Pour consulter :
sysctl net.core.rmem_default
sysctl net.core.rmem_max
sysctl net.ipv4.udp_mem
net.core.netdev_max_backlog
En cas de probleme, on peut augmenter la taille de ce buffer. (temporairement avec commande ou /proc/... et définitivement avec /etc/systcl.d/
sysctl -w net.core.rmem_default=20000000
sysctl -w net.core.rmem_max=30000000
sysctl -w net.ipv4.udp_mem='262144 327680 393216'
sysctl -w net.core.netdev_max_backlog=2000Comment savoir qu'on a des drop udp ?
netstat -su
Sinon il y a /proc/net/udp qui contient une ligne par socket udp avec le port (attention en hexadecimal), la taille du buffer utilisé, (s'inquiéter si rxqueue est différent de zéro) et enfin la dernière colonne, les drops !
alors si vous avez des drops, il faut revoir l'application,.
Augmenter la taille du buffer est utile seulement si ces drops sont du à des "burst" (des pics d'activité qui n'arrivent pas souvent), un plus grand buffer permettra d'absorber ces pics !En encore plus interactif : netstat -c --udp -an
todo : trouver les commandes équivalentes avec ss
https://github.com/etsy/statsd/issues/318
https://www.assembla.com/spaces/LogZillaWiki/wiki/UDP_Buffers
http://answers.splunk.com/answers/7001/udp-drops-on-linux.html
-
Mis apuntes de.. Raspberry Pi entre otros
November 27, 2014 - permalink - http://misapuntesde.com/post.php?id=232ah genial pour balancer du stream sur la tv!
-
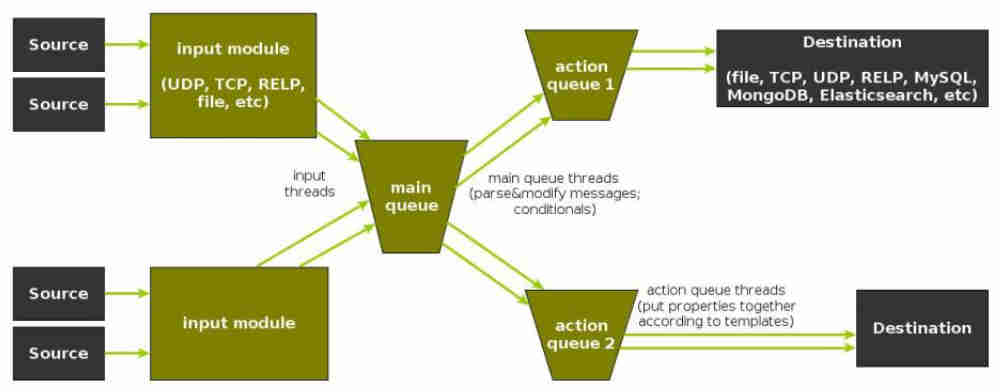
Performance Tuning&Tests for the Elasticsearch Output
November 27, 2014 - permalink - http://www.rsyslog.com/performance-tuning-elasticsearch/Pour envoyer direct dans ES depuis rsyslog
(se passer de logstash devient donc possible dans certains cas)
-
How can I view all historical changes to a file in SVN - Stack Overflow
November 26, 2014 - permalink - http://stackoverflow.com/questions/282802/how-can-i-view-all-historical-changes-to-a-file-in-svnSympa la fonction dans les commentaires, mais pour un gros historique, penser à rajouter un "-l 3" au svn log pour avoir seulement l'historique des 3 derniers changements.
La version modifée avec le "-l 3" :
!/bin/bash
history_of_file
Outputs the full history of a given file as a sequence of
logentry/diff pairs. The first revision of the file is emitted as
full text since there's not previous version to compare it to.
function history_of_file() {
url=$1 # current url of file
svn log -l 3 -q $url | grep -E -e "^r[[:digit:]]+" -o | cut -c2- | sort -n | {first revision as full text
    echo
    read r
    svn log -r$r $url@HEAD
    svn cat -r$r $url@HEAD
    echo
remaining revisions as differences to previous revision
    while read r
    do
        echo
        svn log -r$r $url@HEAD
        svn diff -c$r $url@HEAD
        echo
    done
}
}
history_of_file $1
-
Kibana4 liste de fields
November 25, 2014 - permalink - https://links.infomee.fr/shaare/ANfw7ADans la vue Discover de Kibana4, si vous ne voyez pas tous les champs d'une entrée....
Tentez cette manip' : Settings > Indices > Select your indice (logstash-*) > then refresh..
Cette liste a parfois du mal à se rafraichir si il y a trop de documents/de champs (PS : plusieurs heureuse de debug sans résultat, la solution m'a été donnée sur irc : freenode#kibana) thx rashidkpc
-
Plugins
November 23, 2014 - permalink - http://www.elasticsearch.org/guide/en/elasticsearch/reference/current/modules-plugins.htmlLe système de plugin d'elasticsearch est vraiment bien foutu.
Quelques plugins sympa pour avoir un aperçu de la santé de son cluster :
https://github.com/karmi/elasticsearch-paramedic
https://github.com/mobz/elasticsearch-head
https://github.com/lukas-vlcek/bigdeskPour les installer, c'est à chaque fois pareil, en une ligne :
/usr/share/elasticsearch/bin/plugin -install lukas-vlcek/bigdesk
/usr/share/elasticsearch/bin/plugin -install karmi/elasticsearch-paramedic
/usr/share/elasticsearch/bin/plugin -install mobz/elasticsearch-headPour savoir quels plugins sont installés et par quelle urls y accéder :
curl -s -XGET 'http://localhost:9200/_nodes?pretty' | grep plugin
-
-
rate limiting
November 19, 2014 - permalink - http://www.rsyslog.com/tag/rate-limiting/rsyslog intègre une limitation soft pour ne pas pourrir les IO en cas de mass logs non voulus
Dans certains cas les valeurs par défaut sont un peu faible, suffit de les up un peu en surveillant les io disk ;)
-
linux - Add up a column of numbers at the Unix shell - Stack Overflow
November 19, 2014 - permalink - http://stackoverflow.com/questions/926069/add-up-a-column-of-numbers-at-the-unix-shell| awk '{total = total + $1}END{print total}'
find . ! -newer /tmp/file2015 -exec ls -l --block-size=M {} \; |cut -d' ' -f5|sed 's/M//'| awk '{total = total + $1}END{print total}'
-
-
Elasticsearch "Yellow" cluster status explained | Chris Simpson - Software Developer
November 19, 2014 - permalink - http://chrissimpson.co.uk/elasticsearch-yellow-cluster-status-explained.htmlJe me demandais pourquoi le status de mes index étaient à yellow, en fait c'est tout à fait normal dans un cluster mono node :-)
-
-
Welcome to Attic — Attic - Deduplicating Archiver 0.13 documentation
November 19, 2014 - permalink - https://attic-backup.org/Découverte sympa, même si je reste fan de rsnapshot et de ses hardlink
-
-
The Puppet File Server — Documentation — Puppet Labs
November 18, 2014 - permalink - https://docs.puppetlabs.com/guides/file_serving.htmlSi vous utilisez le fileserver de puppet et que vous gérez beaucoup de petits fichiers avec, il y a surement des optimisations à faire !
En effet pour chaque fichier, le client va demander un hash au serveur et en établissant à chaque fois une nouvelle connexion tcp... le temps perdu 2,5 secondes pour 10 fichiers..
Pour voir tout ça, rdv dans les logs du puppet master et regarder les lignes : GET /production/file_metadata pour vous donner une idée
La solution est de se passer du fileserver pour ces petits fichiers et de les inclure directement dans le catalogue, en utilisant :
content => file(path)
au lieu de source => puppet:///
Ici on est passé de 14seconde à 5,5seconde
-
-
Voxygen | Voxygen
November 17, 2014 - permalink - http://www.voxygen.fr/frVoxygen, éditeur de la synthèse vocale de dernière génération, expert en voix expressives, vous accompagne dans la définition de votre stratégie vocale.
-
-
-
kairosdb/kairosdb
November 14, 2014 - permalink - https://github.com/kairosdb/kairosdbIl existe plusieurs alternatives à carbon, la plus connu étant surement influxdb. Celle ci est basée sur cassandra!
+https://github.com/kairosdb/kairos-carbon
via arnaudb
-
FreedomLayer | Articles | Intro to Distributed Hash Tables (DHTs)
November 13, 2014 - permalink - http://www.freedomlayer.org/articles/dht_intro.htmlLe principe des table de hash distribuées
- http://www.suumitsu.eu/2014/12/11/lapres-tpb-dht-infohash-et-indexation/
- DEFCON 18: Crawling BitTorrent DHTs for Fun 1/2 https://www.youtube.com/watch?v=v4Q_F4XmNEc
- DEFCON 18: Crawling BitTorrent DHTs for Fun 1/2 https://www.youtube.com/watch?v=mO3DfLtKPGs
- https://www.usenix.org/legacy/event/woot10/tech/full_papers/Wolchok.pdf
-
-
-
6.10.1. tcp(), tcp6(), udp() and udp6() source options
November 7, 2014 - permalink - http://www.balabit.com/sites/default/files/documents/syslog-ng-ose-3.3-guides/en/syslog-ng-ose-v3.3-guide-admin-en/html/reference_source_tcpudp.htmlWhen receiving messages using the UDP protocol, increase the size of the UDP receive buffer on the receiver host (that is, the syslog-ng OSE server or relay receiving the messages). Note that on certain platforms, for example, on Red Hat Enterprise Linux 5, even low message load (~200 messages per second) can result in message loss, unless the so_rcvbuf() option of the source is increased. In such cases, you will need to increase the net.core.rmem_max parameter of the host (for example, to 1024000), but do not modify net.core.rmem_default parameter.
As a general rule, increase the so_rcvbuf() so that the buffer size in kilobytes is higher than the rate of incoming messages per second. For example, to receive 2000 messages per second, set the so_rcvbuf() at least to 2 097 152 bytes.
-
Comment filtrer la sortie d'erreur (seulement)
November 7, 2014 - permalink - https://links.infomee.fr/shaare/-D0dqQPrenons un bash qui ouput sur sa sortie standard (stdout) et sur sa sortie d'erreur (stderr) :
cat test.bash
echo good
echo bad >&2
echo vanish >&2
echo good!Comment faire pour rediriger la sortie standard vers un fichier (ou /dev/null pour l'exemple) et filter la sortie d'erreur pour retirer la ligne "vanish" ?
Pour ça il faut utiliser un process substitution :
/root/test.bash 2> >(grep -v vanish >&2) >/dev/null
Bien pratique dans un crontab pour recevoir un peu moins de mail lorsqu'on a des "erreurs" acceptables (rsync vanished par exemple)
SHELL=/bin/bash
* * * * * root /root/test.bash 2> >(grep -v vanish >&2) >/dev/nullPour en savoir plus sur les process substitution : http://tldp.org/LDP/abs/html/process-sub.html
-
Faire suivre les messages Rsyslog vers Logstash - Wooster
November 6, 2014 - permalink - https://wooster.checkmy.ws/2014/07/rsyslog-json-logstash/Pas con le coup de bien formater les logs pour que logstash ait moins de boulot de parsing de son côté.
-
Docker In-depth: Volumes · Container42
November 5, 2014 - permalink - http://container42.com/2014/11/03/docker-indepth-volumes/Bon article, résume très bien les volumes dans docker
-
When Logstash and Syslog go wrong – Kartar.Net
November 5, 2014 - permalink - http://kartar.net/2014/09/when-logstash-and-syslog-go-wrong/Ok j'ai eu le meme probleme : le syslog input de logstash tombe systématiquement en grok failure..
Remplaçable facilement par un udp input !
-
git diff - Show all changed files between two Git commits - Stack Overflow
November 5, 2014 - permalink - http://stackoverflow.com/questions/1552340/show-all-changed-files-between-two-git-commitsJe prends de plus en plus le réflexe de "git init" dans certains dossiers un peu chaud qui bougent beaucoup comme des dossiers de configuration..
Et là arrive le moment où je me pose la question : qu'est ce que j'ai touché depuis que j'ai fais mon git ini ? Et voilà la commande magique qui répond à ma question :
git diff --name-only SHA1 SHA2
Après si vous voulez la liste entre le premier et le dernier commit :
git diff --name-only HEAD $(git log --format=%H | tail -1)
-
Utiliser une commande en destination de syslog
October 30, 2014 - permalink - http://www.softpanorama.org/Logs/Syslog_ng/configuration_examples.shtmldestination mail-alert-perl { program("/usr/local/bin/syslog-mail-perl"); };
-
Crontab Redirect to Log File With Date in Name
October 30, 2014 - permalink - http://www.idevelopment.info/data/Oracle/DBA_tips/Unix/UNIX_7.shtmlBon à savoir, pour rediriger la sortie standard d'un cron dans un fichier avec la date, penser à échapper les "%"
/path/to/log/dir/$(date +\%Y-\%m-\%d).log
-
-
Dockerfile RUN, CMD, ENTRYPOINT
October 28, 2014 - permalink - https://links.infomee.fr/shaare/tKS8aQD'après la doc :
don't confuse RUN with CMD.
RUN actually runs a command and commits the result;
CMD does not execute anything at build time, but specifies the intended command for the image.
An ENTRYPOINT helps you to configure a container that you can run as an executable. That is, when you specify an ENTRYPOINT, then the whole container runs as if it was just that executable.
Unlike the behavior of the CMD instruction, The ENTRYPOINT instruction adds an entry command that will not be overwritten when arguments are passed to docker run. This allows arguments to be passed to the entry point, i.e. docker run -d will pass the -d argument to the entry point.
You can specify parameters either in the ENTRYPOINT JSON array (as in "like an exec" above), or by using a CMD instruction. Parameters in the ENTRYPOINT instruction will not be overridden by the docker run arguments, but parameters specified via a CMD instruction will be overridden by docker run arguments.
Le RUN sert à build l'image
Le CMD et l'ENTRYPOINT servent au moment du docker run
Donc au final, il vaut mieux avoir un ENTRYPOINT avec des paramètres qu'on ne peut pas écraser (non overridable)
Pourquoi pas un CMD avec des paramètres par défauts overridable
-
-
-
-
-
Docker on C1
October 27, 2014 - permalink - https://blog.cloud.online.net/2014/10/27/docker-on-c1/docker dispo sur le lab d'online
-
Cloud computing & object storage - RunAbove
October 27, 2014 - permalink - https://www.runabove.com/index.xmlhebergement à base de docker
-
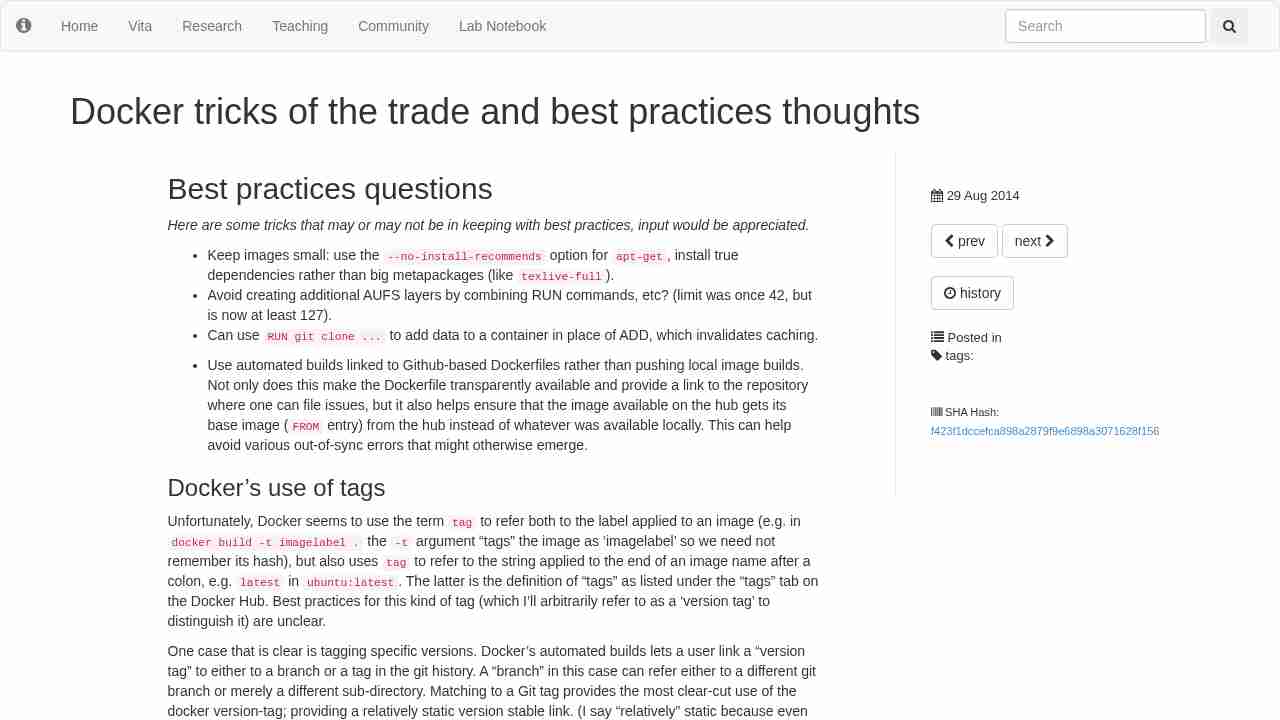
Docker tricks of the trade and best practices thoughts
October 26, 2014 - permalink - http://www.carlboettiger.info/2014/08/29/docker-notes.htmlUse automated builds linked to Github-based Dockerfiles rather than pushing local image builds. Not only does this make the Dockerfile transparently available and provide a link to the repository where one can file issues, but it also helps ensure that the image available on the hub gets its base image (FROM entry) from the hub instead of whatever was available locally. This can help avoid various out-of-sync errors that might otherwise emerge.
-
Question #170794 : Questions : Graphite
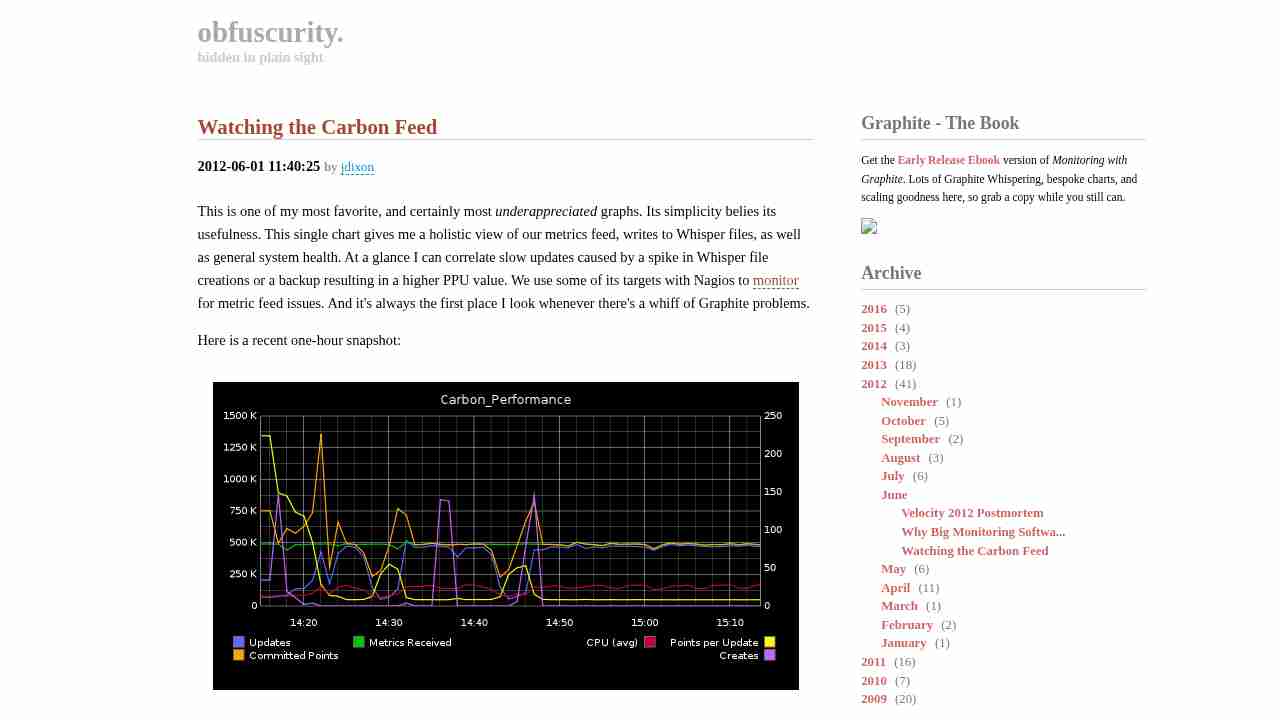
October 24, 2014 - permalink - https://answers.launchpad.net/graphite/+question/170794Encore une discussion intéressante sur les perf de graphite. Ce qu'il faut retenir c'est que le botteneck peut se situer au niveau du CPU ou au niveau du disque (la RAM en général ce n'est pas un probleme, meme si bien sur, il faut la surveiller)
Pour connaitre l'utilisation du CPU de carbon-cache, une metric est envoyé par le daemon dans carbon.agents.graphite-x.cpuUsage
Pour connaitre l'utilisation du disk, on se sert de iostat -dmx 1 2 (merci arnaud)
Si le disque est trop haut (entre 50 et 75), il faut le soulager en baissant dans la conf de carbon le max update par seconde.
Ce qui aura pour effet d'augmenter la taille du cache et donc de faire plus travailler le CPU..
Au contraire si le CPU est chargé mais que le disque ne fait rien, il faut augmenter le max update par seconde.
En trouvant le bon équilibre on peut exploiter au maximum le hardware disponible
-
Trouver son adresse ip public en ligne de commande
October 24, 2014 - permalink - https://links.infomee.fr/shaare/v-CE1wcurl http://bot.whatismyipaddress.com
Une parmi d'autres qui a l'avantage d'être rapide ;)
-
-
-