-
-
-
-
-
-
-
-
-
-
-
-
-
rubber/collectd-cassandra.conf at master · rubber/rubber
January 12, 2015 - permalink - https://github.com/rubber/rubber/blob/master/templates/cassandra/config/rubber/role/cassandra/collectd-cassandra.confUn exemple de conf pour remonter les data de la JMX cassandra via collectd
-
-
-
-
-
-
-
-
-
-
-
Alteroot | Replace a dead node in Cassandra
March 12, 2014 - permalink - http://blog.alteroot.org/articles/2014-03-12/replace-a-dead-node-in-cassandra.htmlComment remplacer un noeud cassandra en conservant la même ip
-
Jmxterm - CyclopsGroup.org Wiki
December 27, 2013 - permalink - http://wiki.cyclopsgroup.org/jmxtermTool pour monitorer des values exposées en jmx
$>beans
$>bean java.lang:name=G1\ Eden\ Space,type=MemoryPool
$> info
$> get XXXecho "beans" | java -jar jmxterm-1.0-alpha-4-uber.jar --url localhost:9010 -n|grep -i garbage
echo "get -b java.lang:type=Memory HeapMemoryUsage" | java -jar jmxterm-1.0-alpha-4-uber.jar --url localhost:9010 -n
echo "get -b java.lang:name=G1\ Eden\ Space,type=MemoryPool CollectionUsage" | java -jar jmxterm-1.0-alpha-4-uber.jar --url localhost:9010 -n
or use input file
pid=$(ps...)
java -jar jmxterm-1.0-alpha-4-uber.jar -n <<EOFopen $pid
beans
EOF
-
Data repair and performance optimisation with Xebia FR
December 18, 2013 - permalink - http://www.meetup.com/Cassandra-Paris-Meetup/events/144703752/[Summary, full note in Shaarli]
Cassandra Paris Meetup #3 chez Xebia (17 décembre, 18h30). Slides : http://fr.slideshare.net/ClmentLARDEUR/deep-into-cassandra-data-repair-mechanisms-
Mécanismes internes de réparation des données (Clément Lardeur, 45 min), du fonctionnement global à l'implémentation :
- Read Repair : actif par défaut, répare les incohérences entre replicas lors d'une lecture.
- Anti-Entropy (nodetool repair) : répare un noeud complet et ses replicas ; à lancer pour la maintenance, après une panne, à l'ajout d'un noeud...
- Hinted Handoff : actif par défaut ; si une écriture échoue sur un noeud, le coordinateur la garde et la rejoue quand le noeud revient. -
REX optimisation de performances (William Montaz, 45 min) :
- Twenga : real time bidding publicitaire, réponses en moins de 80 ms, infos sur les URLs stockées en clé/data.
- Batch de calcul de prix en "wide row" : peu de clés à la fois mais gros volume de données.
Au programme : caches (key cache, row cache), bloom filters, commitlog, JVM, sharding, driver Java Datastax.
-
-
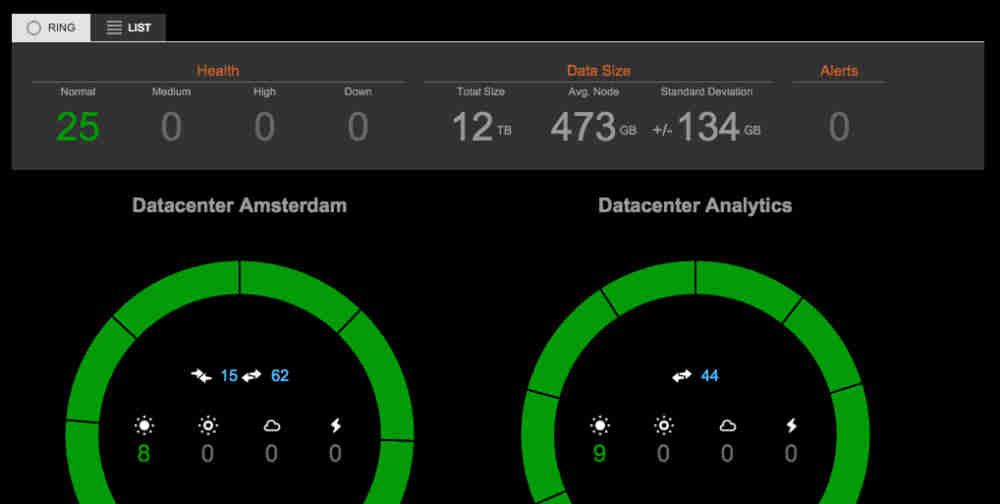
Monitoring a Cassandra cluster | DataStax Cassandra 2.0 Documentation
November 8, 2013 - permalink - http://www.datastax.com/documentation/cassandra/2.0/webhelp/cassandra/operations/ops_monitoring_c.htmlPage chez datastax qui explique comment monitorer cassandra
-
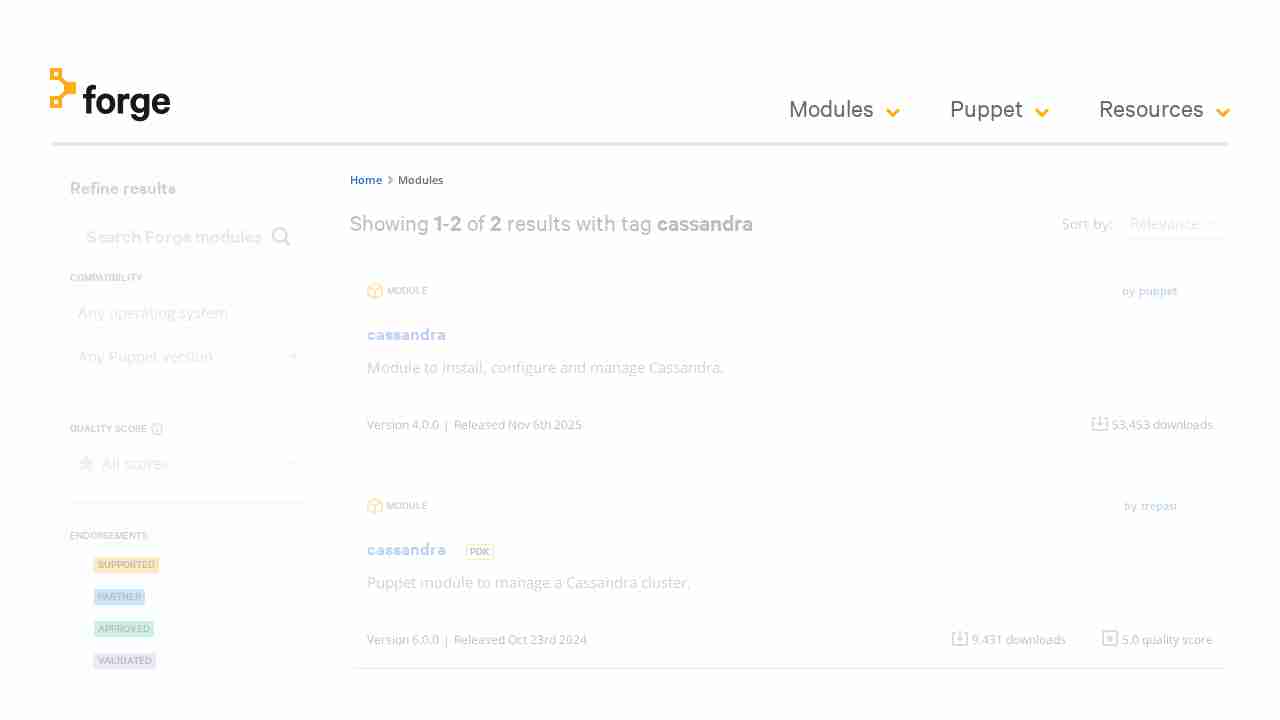
Modules tagged cassandra · Puppet Forge
November 8, 2013 - permalink - https://forge.puppetlabs.com/tags/cassandraModules puppet pour installer cassandra
-
-
Cassandra paris meetup november 2013
November 5, 2013 - permalink - http://fr.slideshare.net/doanduyhai/cassandra-paris-meetup-november-2013-27905781Support du meetup du 05/11/2013
Meetup intéressant, je regrette d'avoir raté le premier, j'espère ne pas louper les suivants :-)PS : c'est nul sur slideshare il faut se connecter pour télécharger le PDF.. Et les liens pour se connecter avec linkedin ou facebook sont cassés, je vais devoir me créer un compte de plus :-(
-
Cassandra Data Modeling Best Practices, Part 1 — eBay Tech Blog
November 5, 2013 - permalink - http://www.ebaytechblog.com/2012/07/16/cassandra-data-modeling-best-practices-part-1/Les best practices du data modeling avec cassandra
Si on dé-normalise, on gagne en performance en lecture mais la modification est plus coûteuse
Il n'y a pas de règle, tout dépend de la situation, il faut trouver un équilibre