-
Job Application for Full Stack Engineer (Growth) at DataCamp
March 15, 2019 - permalink - https://boards.greenhouse.io/datacamp/jobs/1482036Should have a clear understanding of standard web development processes and best practices
Is a strong communicator who can explain technical concepts in an understandable manner
Is comfortable rapidly writing throwaway code that gets the job done -- even if it’s not well-optimized, well-tested, or well-architected
Cares more about the business impact of the work than the elegance of the technical solution
Must be detail-oriented, self-organized and capable of tracking multiple tasks simultaneouslyLol
-
-
-
-
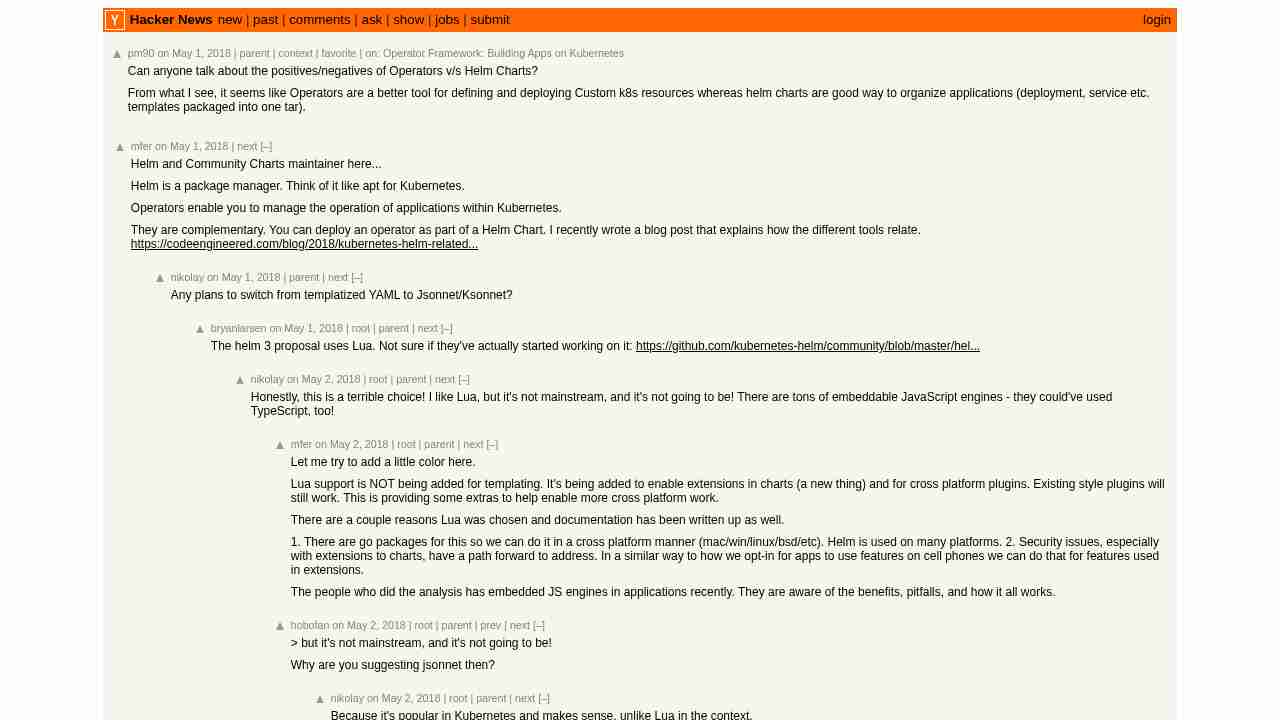
Using Helm without Tiller - Giant Swarm
March 11, 2019 - permalink - https://blog.giantswarm.io/what-you-yaml-is-what-you-get/Pour obtenir les yaml sans installer un helm chart :
helm template \
--values ./values/prometheus.yaml \
--output-dir ./manifests \
./charts/prometheus
-
-
-
-
-
coreos/prometheus-operator: Prometheus Operator creates/configures/manages Prometheus clusters atop Kubernetes
March 9, 2019 - permalink - https://github.com/coreos/prometheus-operatorPrometheus Operator vs. kube-prometheus
The Prometheus Operator makes the Prometheus configuration Kubernetes native and manages and operates Prometheus and Alertmanager clusters. It is a piece of the puzzle regarding full end-to-end monitoring.
kube-prometheus combines the Prometheus Operator with a collection of manifests to help getting started with monitoring Kubernetes itself and applications running on top of it.
https://github.com/coreos/prometheus-operator/tree/master/contrib/kube-prometheus
-
-
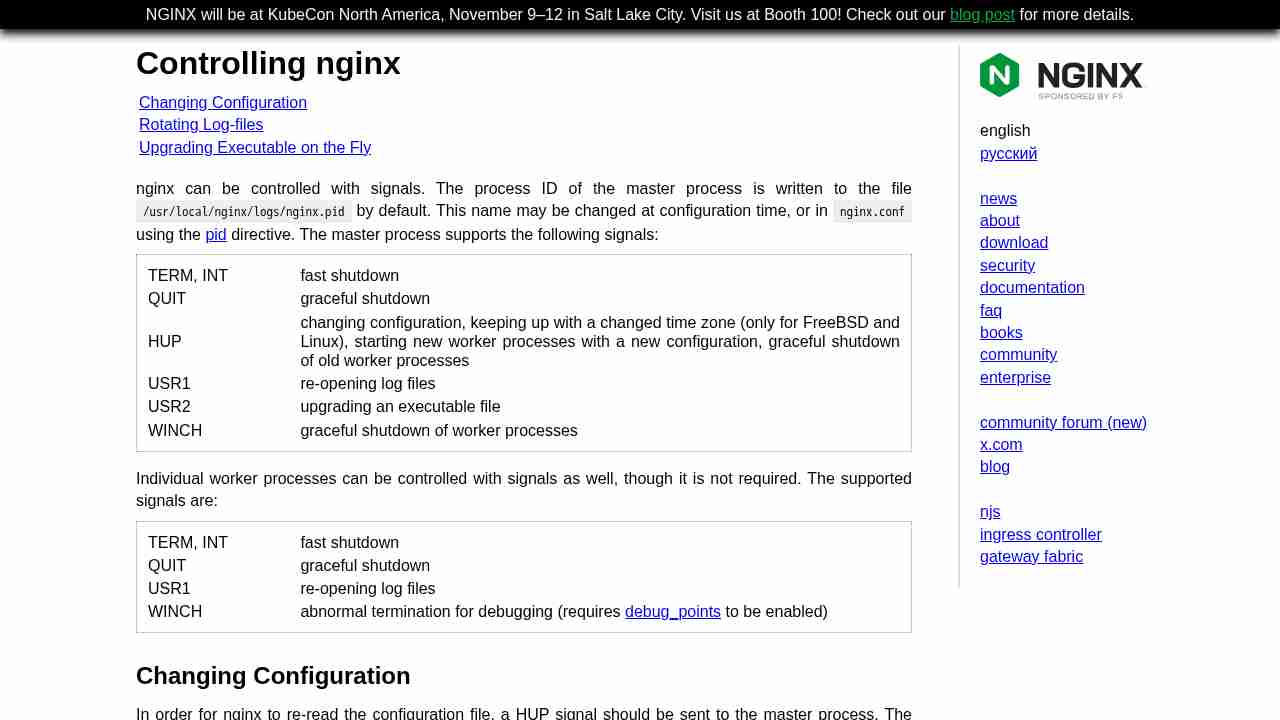
Controlling nginx
March 8, 2019 - permalink - http://nginx.org/en/docs/control.htmlPour un graceful shutdown de nginx, il faut un SIGQUIT
Kubernetes envoie du SIGTERM alors on peut utiliser un preStop script pour être + cool
https://kubernetes.io/docs/tasks/configure-pod-container/attach-handler-lifecycle-event/#define-poststart-and-prestop-handlersOn peut aussi utiliser le preStop pour s'assuret que le container nginx sidecar s'arrête bien avant l'autre container en posant un lock dans un shared volume. Le preStop de l'autre container va attendre que le lock soit supprimé pour se couper. Le preStop du nginx va supprimer le lock quand il a bien terminé.
On crée le lock dans un postStart
via Meetup k8s bbc speaker
-
-
-
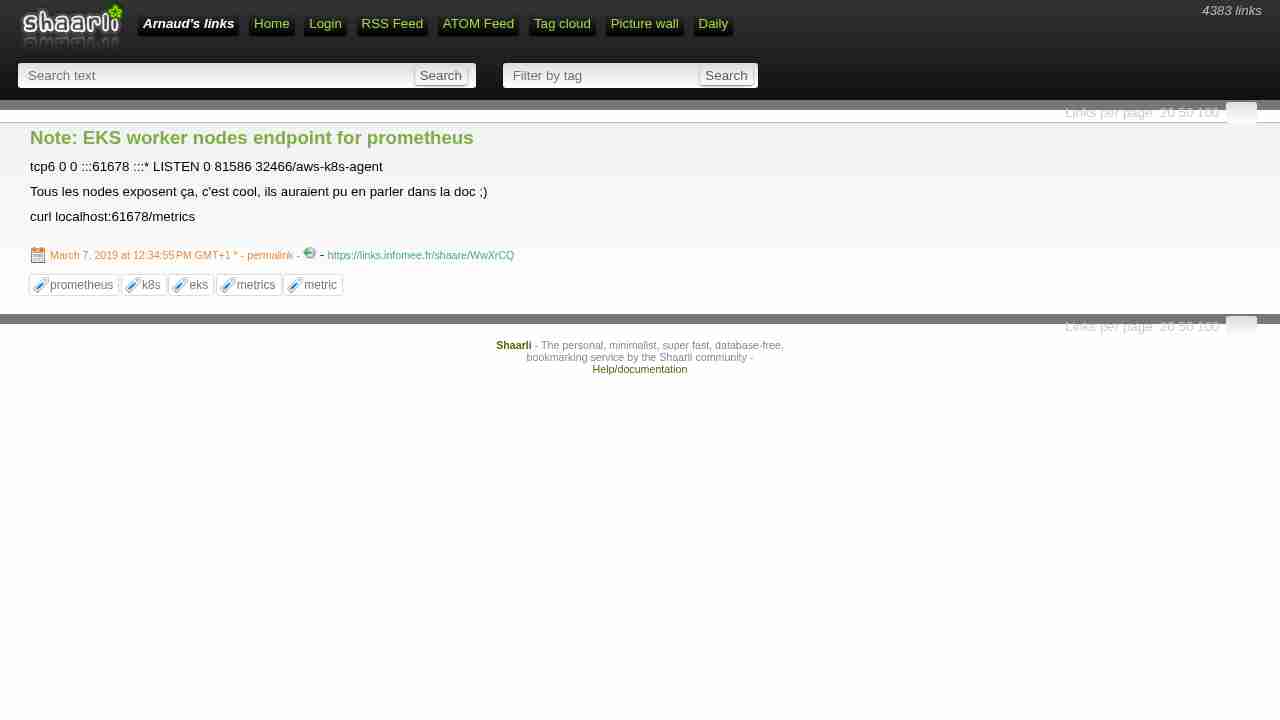
Note: EKS worker nodes endpoint for prometheus
March 7, 2019 - permalink - https://links.infomee.fr/shaare/WwXrCQtcp6 0 0 :::61678 :::* LISTEN 0 81586 32466/aws-k8s-agent
Tous les nodes exposent ça, c'est cool, ils auraient pu en parler dans la doc ;)
curl localhost:61678/metrics
-
kubernetes-incubator/external-dns: Configure external DNS servers (AWS Route53, Google CloudDNS and others) for Kubernetes Ingresses and Services
March 6, 2019 - permalink - https://github.com/kubernetes-incubator/external-dnsmarche bien, j'ai quand même créé une nouvelle zone et donné les droits dans le role IAM seulement sur celle-ci pour ne pas tout mélanger
Il faut désactiver le upsert only sinon les entrées DNS ne sont pas supprimées quand le service est supprimé et quand on le recrée, il n'arrive pas à update
-
Kubernetes/kubectl Ignores Annotation Changes | 8bitzen
March 6, 2019 - permalink - https://blog.8bitzen.com/05-07-2018-k8s-kubecl-ignores-annotation-changes/ça m'est arrivé, bien galère..
Il faut ajouter des quotes aux value des annotations pour qu'elles soient prise en compte lors d'un apply
-
Note: Kubernetes rollout history
March 6, 2019 - permalink - https://links.infomee.fr/shaare/7sdJlAQuand on modifie un deployment avec un kubectl apply -f chemin/vers/fichier.yaml
Le rollout history n'est pas complété, aucune révision n'est créée
Il faut ajouter un --record à la commande précédente ce qui va créer une révision avec un "change cause" qui va reprendre la commande :REVISION CHANGE-CAUSE
10 kubectl apply --filename=k8s/preprod/ --record=truePas mal mais on peut faire mieux en ayant par exemple le hash du commit (ou le numéro du build..) dans ce "change cause"
Pour ça, dans la CI/CD, on peut renommer par exemple le dossier avant de lancer le kubectl apply -f, ce qui donnera :
REVISION CHANGE-CAUSE
11 kubectl apply --filename=k8s/preprod-a5bcec9 --record=trueEt comme ça on a un rollout history bien propre pour s'y retrouver ;)
-
-
Define a Command and Arguments for a Container - Kubernetes
March 5, 2019 - permalink - https://kubernetes.io/docs/tasks/inject-data-application/define-command-argument-container/#define-a-command-and-arguments-when-you-create-a-poddans un Dockerfile : ENTRYPOINT + CMD
chez k8s : command + args
-
Git: Find the most recent common ancestor of two branches - Stack Overflow
March 4, 2019 - permalink - https://stackoverflow.com/questions/1549146/git-find-the-most-recent-common-ancestor-of-two-branchesgit merge-base branch2 branch3
050dc022f3a65bdc78d97e2b1ac9b595a924c3f2git merge-base HEAD origin/master
-
-
-
-
-
-
Introduction to environments and deployments | GitLab
February 27, 2019 - permalink - https://docs.gitlab.com/ee/ci/environments.html#manually-deploying-to-environmentsJe cherchais à déployer le même build sur un env de preprod et ensuite sur la prod si le build est ok
Ce qui se fait très bien "à l'ancienne" avec Jenkins/Bamboo :
- on a une étape de build qui va créé un artifact
- et une étape de deploy completement indépendante qui permet de déployer un artifact qu'on choisit sur un env en particulierJe ne retrouvais pas cette logique dans les outils plus récents car le deploy est toujours lié au build donc je ne voyais pas comment faire..
La clé est dans la possibilité de pouvoir arrêter un job, de le mettre en pause pour pouvoir le déclencher plus tard si on le souhaite
Donc pour un commit push sur un master, le workflow va se déclencher...
- tests, builds...
- deploy sur preprod
- deploy sur prod en HOLDSi on voit que tout est ok sur preprod, on peut venir resume le deploy prod ! on va utiliser le même build qu'on a testé sur la preprod
C'est le même principe, on veut check la preprod avant de déployer la prod en utilisant le même build, mais implémenté différement
L'équivalent chez circleci :
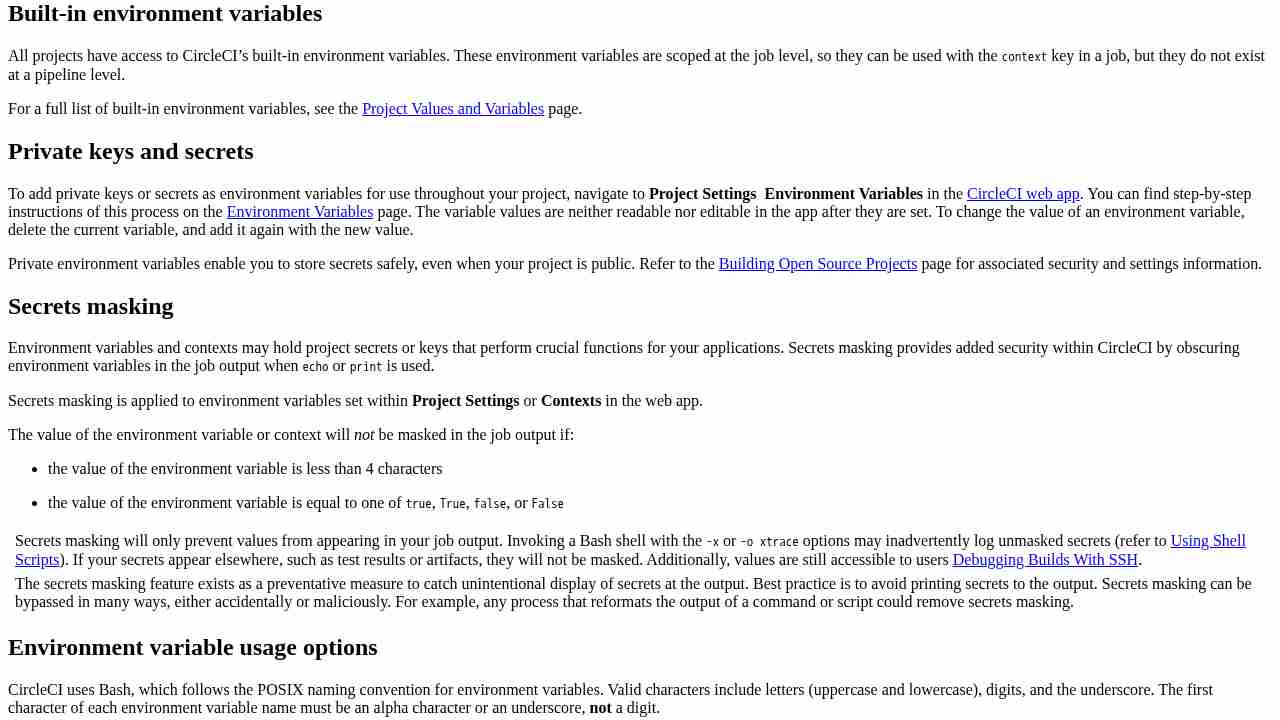
https://circleci.com/blog/manual-job-approval-and-scheduled-workflow-runs/
https://circleci.com/docs/2.0/workflows/#holding-a-workflow-for-a-manual-approvalEt chez Jenkins (récent) :
https://jenkins.io/doc/pipeline/tour/deployment/#asking-for-human-input-to-proceed
-
Should I use Logstash or Elasticsearch ingest nodes? | Elastic
February 26, 2019 - permalink - https://www.elastic.co/blog/should-i-use-logstash-or-elasticsearch-ingest-nodesDans la plupart des cas, on peut maintenant oublier logstash et utiliser les ingest node (pipeline) d'elasticsearch
EFK (Elasticsearch, Filebeat, Kibana)
-
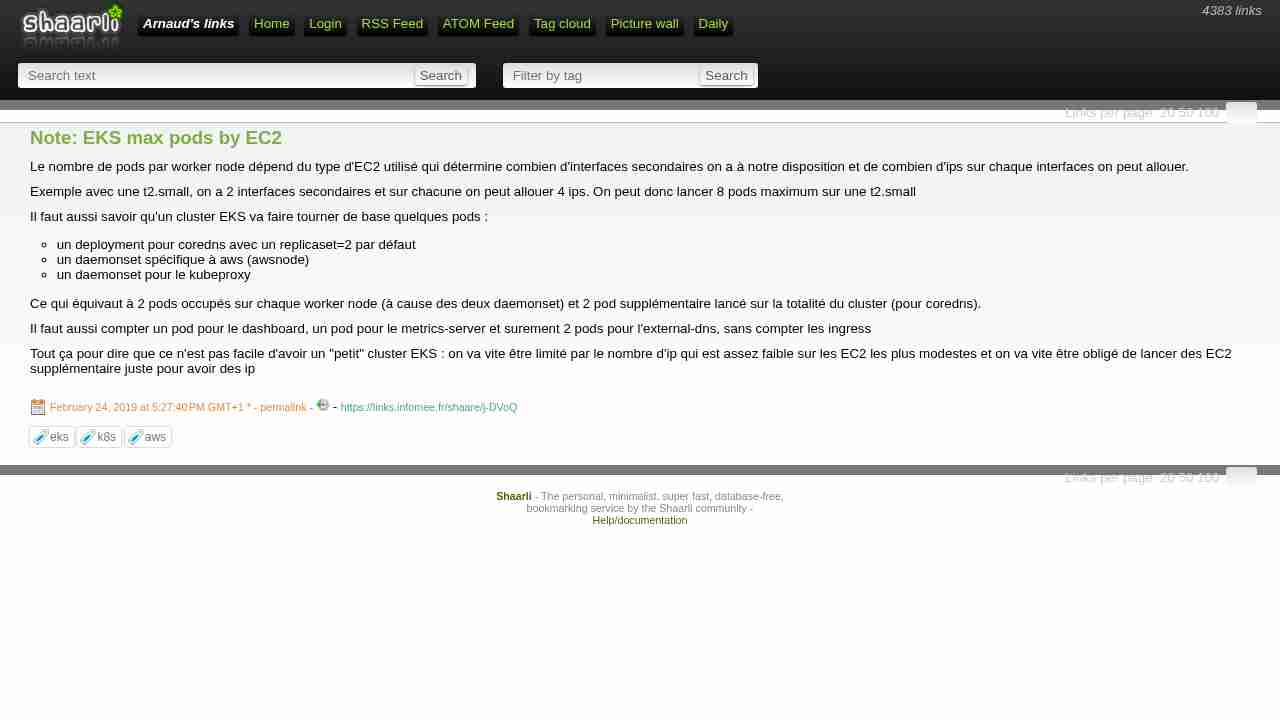
Note: EKS max pods by EC2
February 24, 2019 - permalink - https://links.infomee.fr/shaare/j-DVoQLe nombre de pods par worker node dépend du type d'EC2 utilisé qui détermine combien d'interfaces secondaires on a à notre disposition et de combien d'ips sur chaque interfaces on peut allouer.
Exemple avec une t2.small, on a 2 interfaces secondaires et sur chacune on peut allouer 4 ips. On peut donc lancer 8 pods maximum sur une t2.small
Il faut aussi savoir qu'un cluster EKS va faire tourner de base quelques pods :
- un deployment pour coredns avec un replicaset=2 par défaut
- un daemonset spécifique à aws (awsnode)
- un daemonset pour le kubeproxyCe qui équivaut à 2 pods occupés sur chaque worker node (à cause des deux daemonset) et 2 pod supplémentaire lancé sur la totalité du cluster (pour coredns).
Il faut aussi compter un pod pour le dashboard, un pod pour le metrics-server et surement 2 pods pour l'external-dns, sans compter les ingress
Tout ça pour dire que ce n'est pas facile d'avoir un "petit" cluster EKS : on va vite être limité par le nombre d'ip qui est assez faible sur les EC2 les plus modestes et on va vite être obligé de lancer des EC2 supplémentaire juste pour avoir des ip
-
APIServer dry-run and kubectl diff - Kubernetes
February 13, 2019 - permalink - https://kubernetes.io/blog/2019/01/14/apiserver-dry-run-and-kubectl-diff/Too bad dry run and diff only available on 1.13
EKS is 1.11 only atm ;-(
-
Performance tuning for volume mounts (shared filesystems) | Docker Documentation
February 12, 2019 - permalink - https://docs.docker.com/docker-for-mac/osxfs-caching/tweak volume pour perf docker sous mac
-
Services - Kubernetes
February 9, 2019 - permalink - https://kubernetes.io/docs/concepts/services-networking/service/#elb-access-logs-on-awsHow to configure LoadBalancer (ELB) populated by k8s in aws (eks)
-
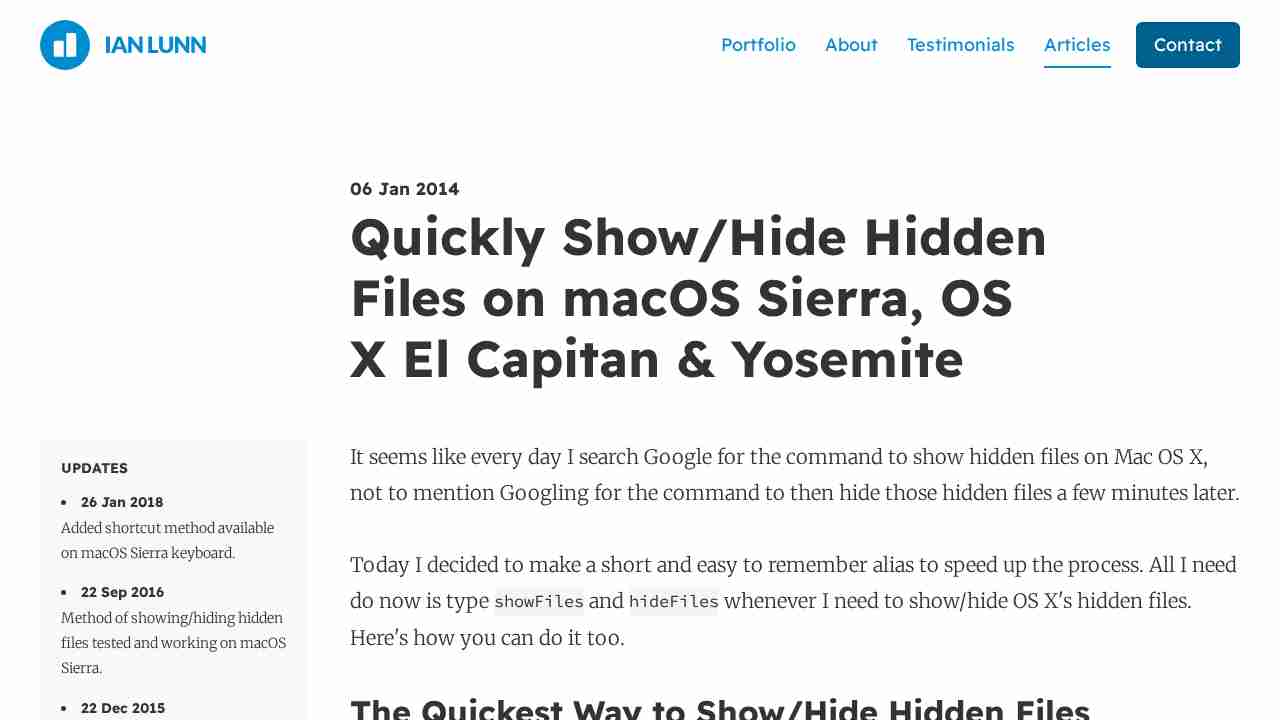
Quickly Show/Hide Hidden Files on macOS Sierra, OS X El Capitan & Yosemite | Ian Lunn - Front-end Developer
February 9, 2019 - permalink - https://ianlunn.co.uk/articles/quickly-showhide-hidden-files-mac-os-x-mavericks/The Quickest Way to Show/Hide Hidden Files
Since the release of macOS Sierra, when in Finder, it is now possible to use the shortcut:
CMD + SHIFT + .
-
-
-
Note: gnu sed on macos
January 29, 2019 - permalink - https://links.infomee.fr/shaare/HZ6B4wbrew install gnu-sed
PATH="/usr/local/opt/gnu-sed/libexec/gnubin:$PATH"feel better
-
-
-
-
-
-
-
-
-
-
-
-
-
-